ruby version update でやっている流れのメモ
最近 ruby と rails の version update を進めている中での、ruby についての自分の流れメモです
やっていること
- RSS を購読して継続的に情報をキャッチアップ
- リリース差分 commit log を全て確認、アプリケーションコードに影響がありそうな変更を洗い出す
- 変更背景を理解するため ruby trunk と ruby trunk changes を確認
- アプリケーション動作確認 & 問題あれば修正対応
RSS で更新情報キャッチアップ
slack で流れる channel 作って更新情報を逃さないようにしてます
/feed subscribe https://www.ruby-lang.org/en/feeds/news.rss
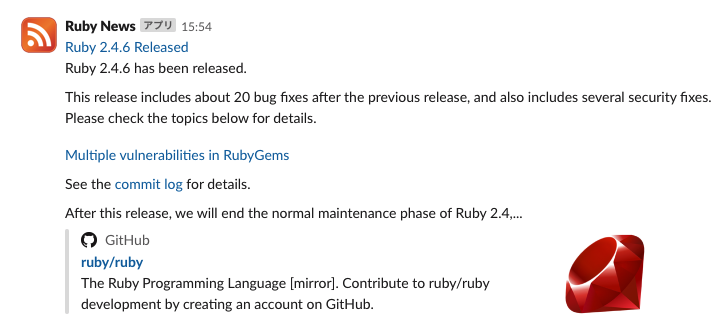
リリース差分 commit log を全て確認
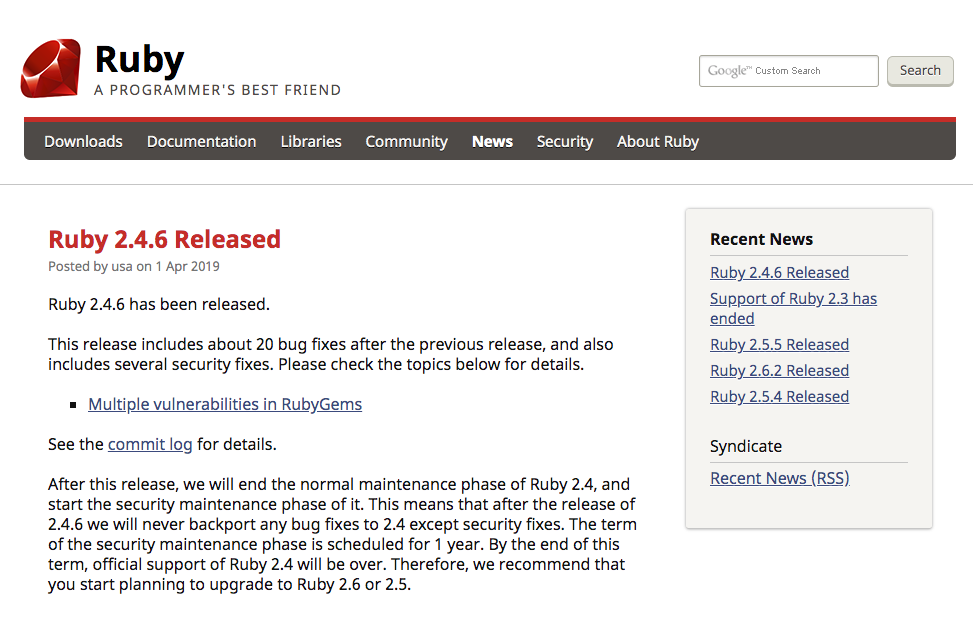
feed の link からリリースノートを確認しにいく
commit log の link から変更差分を確認しにいく
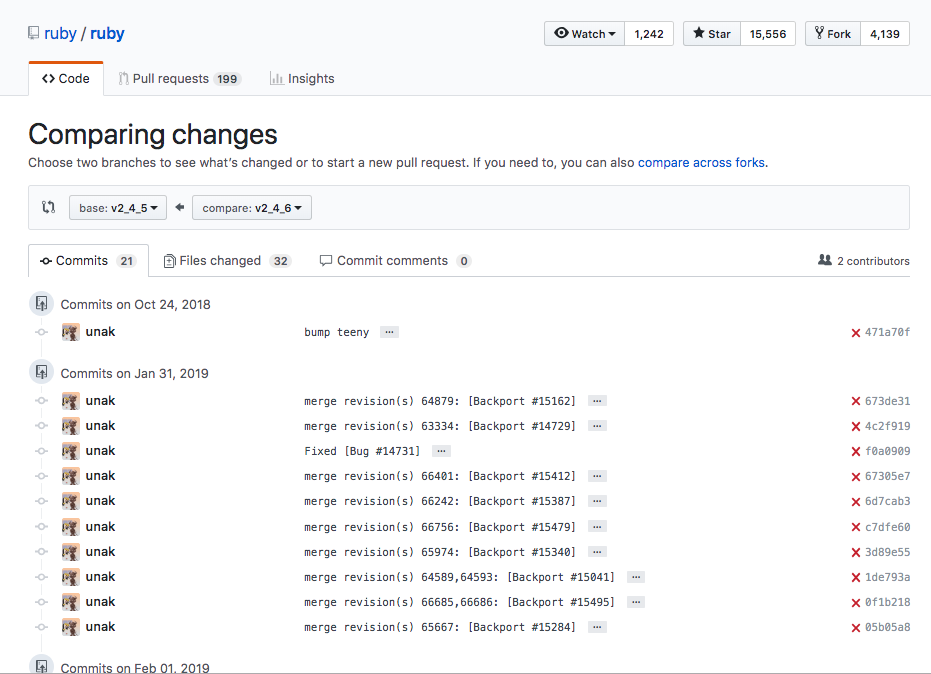
commit それぞれの内容をざっくりと把握していきます
変更背景を理解
merge revision(s) 62872,62873: [Backport #14621] こういう commit log があった場合に
これらをして該当 issue に辿りつき、内容の理解を深めていきます
アプリケーション動作確認 & 問題あれば修正対応
変更コードの内容と変更された背景を理解したら 最後は自分たちのコードに影響あるか?を探っていきます
- テストが通ることの確認
- 主要機能の簡易動作確認
- 変更差分から洗い出した影響箇所を追加で動作確認
これらの項目で問題が見つかったら、修正してリリース
こんな流れでやっていくようになりました
おしまい
Batchとかの実行履歴を残す処理を、yield 使って修正した時のメモ
元々のコード
module Batch
  class Sample
    def execute
      background_job_history = BackgroundJobHistory.start
      begin
        # 実処理
        background_job_history.finish(error: false)
      rescue => e
        background_job_history.finish(error: true)
      end
    end
  end
end
こういう感じのコード(あくまでこういう感じ)でBatchの実行履歴みたいなのを記録していく処理があった。 BackgroundJobHistoryという記録用のModelは、BatchとWorkerとか複数から呼び出される
思ったこと
- ちょっと毎回エラーハンドリングと記録する処理やるの漏れありそうだな
- 最初はBatchのBaseClassにまるっともっていこうかな?と思ったけどWorkerもあるなぁ、BackgroundJobHistory側に状況に合わせて記録するって部分任せよう
- 同僚がtransactionみたいにblockでよしなに処理されるといいなって言っていた
修正したコード
module Batch
  class Sample
    def execute
      BackgroundJobHistory.recording do
        # 実処理
      end
    end
  end
end

Class BackgroundJobHistory
  class << self
    def recording
      background_job_history = create
      begin
        yield
      rescue => e
        background_job_history.error
        raise e
      end
      background_job_history.done
    end
  end
end
履歴を記録するよってのと、どの処理の?っていうのをyieldつかって表現したよってメモでした
pyenvとpipenvによる環境構築
僕は業務上、開発と環境構築をrubyとpythonのどちらもやります。
そのためrubyだとこうでpythonだとこうと、頭の切り替えがよく起きるのです。
rubyとpythonの行き来する上で、操作感覚が似ていることはとても助かります。
pyenvのおかげで、rbenvと似た感覚でversion managementをできるようになりました。
一方アプリケーション固有の依存package managementにおいては、bundlerと似た感覚で操作できるものに出会えていませんでした。
今回はpipenvが僕の悩みをある程度解決してくれそうだったので、試してみたメモです。
pyenvによるversion management
Install & setup pyenv
 $ git clone git://github.com/yyuu/pyenv.git ~/.pyenv
 $ echo 'export PYENV_ROOT="$HOME/.pyenv"' >> ~/.bash_profile
 $ echo 'export PATH="$PYENV_ROOT/bin:$PATH"' >> ~/.bash_profile
 $ echo 'eval "$(pyenv init -)"' >> ~/.bash_profile
 $ source ~/.bash_profile
Install & set global version
global設定にするかは適宜変更してください
 $ pyenv install -v 任意のversion
 $ pyenv global 任意のversion
pipenvによるpackage management
Install & setup pipenv
 $ pip install pipenv
 $ pipenv install
Creating a Pipfile for this project...
Creating a virtualenv for this project...
.... 中略(~/.local/share/virtualenvs以下にvirtualenv環境を作ります)....
PipfileとPipfile.lockが増えている
 $ ls
Pipfile     Pipfile.lock
仮想環境での動作確認
動作確認様にboto3をimportするだけのsample.py作成
sample.py
 1 # -*- coding: utf-8 -*-
 2
 3 import boto3
Pipfile内の[packages]にboto3を追加
Pipfile
  1 [[source]]
  2 url = "https://pypi.python.org/simple"
  3 verify_ssl = true
  4
  5 [packages]
  6 boto3 = "*"
再度pipenv install
 $ pipenv install
No package provided, installing all dependencies.
Pipfile found at /path/to/Pipfile. Considering this to be the project home.
Pipfile.lock out of date, updating...
Locking [dev-packages] dependencies...
Locking [packages] dependencies...
Updated Pipfile.lock!
Installing dependencies from Pipfile.lock...
[================================] 7/7 - 00:00:03
....
globalなpython使ってsample.py実行すると当然ImportError
 $ python sample.py
Traceback (most recent call last):
  File "sample.py", line 1, in <module>
    import boto3
ImportError: No module named 'boto3'
pipenv環境下なpython使ってsample.py実行するとimportできるのでエラーなし
$ pipenv run python sample.py
所感
rbenv -> pyenv、bundler -> pipenvと割と近い感覚で使えるようになったのは好感触
envによるpackageを切り分けていくとこを直感的にできるかをもう少し使ってみて確認したいところ
参考
TerraformとTerraformingを運用中のAWSリソースで試してみる
すでに運用中のELB/EC2でのAppサーバ構成と、同等の構成な別環境がほしくなった。
地道に作るよりどうせなら、状態管理とdry runできるTerraformを試そうと思ったのでやってみることにした。
TerraformとTerraformingをinstall
brew install terraform
gem install terraforming
Terraform用のAWS設定を作成
aws.tf として接続設定を用意しておく
provider "aws" {
  region     = "ap-northeast-1"
  access_key = "access_key"
  secret_key = "secret_key"
}
既存のリソースの状態をローカルに再現する
Terraformはステートファイル(terraform.tfstate)という仕組みを使用して、リソースの状態管理をしているのでそれをローカルに再現する。
Terraformingを利用してterraform.tfstateの作成、リソースのtfファイルを作成した。
terraform.tfstate作成
terraforming ec2 --tfstate > terraform.tfstate
terraforming eip --tfstate --merge=terraform.tfstate --overwrite
terraforming elb --tfstate --merge=terraform.tfstate --overwrite
--overwrite オプションをなくせば書き込む前にmerge後の内容を確認もできる
既存EC2関連をひとまとめにしたtfファイル作成
terraforming ec2 > ec2.tf
terraforming eip >> ec2.tf
terraforming elb >> ec2.tf
新規追加するリソースのtfファイル作成
new_ec2.tf
resource "aws_instance" "web" {
    ami                         = "ami-xxxxxx" # 任意のAMI ID
    ebs_optimized               = false
    instance_type               = "t2.small"
    monitoring                  = false
    key_name                    = "nozayasu"

    root_block_device {
        volume_type           = "gp2"
        volume_size           = 8
        delete_on_termination = true
    }

    tags {
        "Name" = "web"
    }
}

resource "aws_eip" "web" {
    instance = "${aws_instance.web.id}"
    vpc      = true
}

resource "aws_elb" "web" {
    name                        = "web"
    subnets                     = ["subnet-xxxxxx", "subnet-xxxxxxx"]
    security_groups             = ["sg-xxxxxx"]
    instances                   = ["${aws_instance.web.id}"]
    cross_zone_load_balancing   = true
    idle_timeout                = 60
    connection_draining         = true
    connection_draining_timeout = 300
    internal                    = false

    listener {
        instance_port      = 80
        instance_protocol  = "http"
        lb_port            = 80
        lb_protocol        = "http"
        ssl_certificate_id = ""
    }

    health_check {
        healthy_threshold   = 10
        unhealthy_threshold = 2
        interval            = 30
        target              = "HTTP:80/index.html"
        timeout             = 5
    }
}
${aws_instance.web.id} で最初に定義したaws_instance.webのinstance_idが取得できる、依存関係が必要なEIPやELBにはそれを利用して一括設定。
変更確認
terraform plan
変更箇所として、 - 表示が出ていた場合は削除扱いなので要確認
状態適応
terraform apply
所感
dry runで差分を確認しながら作業できる安心感があり幸せになった。
参考
AWSリソース(EC2/RDS/ElasticCache)を別アカウントに移行
前提条件
移行元AWSアカウント(A)と、移行先AWSアカウント(B)に接続できる状態であること
EC2の移行
※ AMIは同一リージョンでないと共有できないのだけ注意が必要だった
参考
RDSの移行
- Aで移行したいDBのスナップショットを作成
- A -> B でアカウント間プライベート共有
- B側でプライベート共有スナップショットからDB復元
※ パラメータグループが移行はない。目視diffは厳しいのでCLIでごにょごにょ移行した
参考
- DB スナップショットまたは DB クラスタースナップショットの共有 - Amazon Relational Database Service
- [Amazon RDS] スナップショットの共有機能を試してみた | Developers.IO
- AWS CLIでDBパラメータグループをコピーする – サーバーワークスエンジニアブログ
ElasticCacheの移行
- Aで移行したいElastiCacheのバックアップを作成
- Aでエクスポート用のS3 bucketを作成
- Aでエクスポート用のS3 bucketにElastiCacheのバックアップをエクスポート
aws s3 cp --profile A s3://bucketname/cache.rdb --profile B s3://bucketname/profile使いわけて別アカウントのS3にコピー- BでコピーしたElastiCacheのバックアップからElastiCache復元
※ S3のread権限与えるのを忘れて、いざ復元するときにrestore-failedになりなんで?ってなった
参考
- 発表: Amazon ElastiCache で Redis バックアップおよび復元を実現、クラスターのサイズ変更も可能に | Amazon Web Services ブログ
- バックアップのエクスポート - Amazon ElastiCache
その他
セキュリティグループの移行
前記事で書いたやつでできる
codenize.tools piculetでAWS別アカウントにsecurity groupを移行する
事前準備
アカウントA(既存)の接続情報とアカウントB(移行先)の接続情報を用意
> cat ~/.aws/credentials
[A]
aws_access_key_id = aws_access_key_id_for_A
aws_secret_access_key = aws_secret_access_key_for_A

[B]
aws_access_key_id = aws_access_key_id_for_B
aws_secret_access_key = aws_secret_access_key_for_B
piculet install
> gem install piculet
移行作業
piculet -e -p A -r region -o Groupfile
piculet -a -p B -r region -f Groupfile
--dry-run オプションがあるので -a 実行する時には必ず差分の確認をすると事故がない
-n オプションで、グループ名に設定してるものでフィルタリングしながらの部分適応も可能
詳しくはREADMEにて確認
所感
すでに運用済みの設定を一括でとってきて、それをコードとして運用するための作業をまるっと簡単にしてくれるのが素敵すぎた。
more_itertools chunkedの処理を読む
実際のコードは以下
def chunked(iterable, n):
    """Break *iterable* into lists of length *n*:
        >>> list(chunked([1, 2, 3, 4, 5, 6], 3))
        [[1, 2, 3], [4, 5, 6]]
    If the length of *iterable* is not evenly divisible by *n*, the last
    returned list will be shorter:
        >>> list(chunked([1, 2, 3, 4, 5, 6, 7, 8], 3))
        [[1, 2, 3], [4, 5, 6], [7, 8]]
    To use a fill-in value instead, see the :func:`grouper` recipe.
    :func:`chunked` is useful for splitting up a computation on a large number
    of keys into batches, to be pickled and sent off to worker processes. One
    example is operations on rows in MySQL, which does not implement
    server-side cursors properly and would otherwise load the entire dataset
    into RAM on the client.
    """
    return iter(partial(take, n, iter(iterable)), [])
要素を分解する
実際の処理はここだけ
return iter(partial(take, n, iter(iterable)), [])
iter, partial, takeという処理を組み合わせて実現してる、それぞれみてみる。
iter
https://docs.python.org/3/library/functions.html#iter
イテレータオブジェクトを返してくれる 引数の内容によって振る舞いがかわってくる
>>> iter(1)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'int' object is not iterable
>>> iter("こんにちは")
<str_iterator object at 0x10dbf7c18>
>>> iter("こんにちは", "")
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: iter(v, w): v must be callable
>>> iter(int, 0)
<callable_iterator object at 0x10dbf7cc0>
1つだけ引数を渡す場合、イテレートできないようなオブジェクトだとTypeErrorになる
2つ引数を渡す場合、callできないようなオブジェクトだとTypeErrorになる、callした結果が2つ目の引数と一致するまでcallし続ける
partial
https://docs.python.org/3/library/functools.html#functools.partial
任意のfunctionにおいて、特定引数のdefault値が設定された新たなfunctionを生成してくれる
次みたいなのができるになる
>>> from functools import partial
>>> def say(word):
...     print(word)
...
>>> say("こんにちは")
こんにちは
>>> new_say = partial(say, word="こんばんは")
>>> new_say()
こんばんは
>>> new_say(word="おやすみ")
おやすみ
take
イテレータオブジェクトの頭からn回処理した結果をリストとして返してくれる
def take(n, iterable):
    """Return first *n* items of the iterable as a list.
        >>> take(3, range(10))
        [0, 1, 2]
        >>> take(5, range(3))
        [0, 1, 2]
    Effectively a short replacement for ``next`` based iterator consumption
    when you want more than one item, but less than the whole iterator.
    """
    return list(islice(iterable, n))
ここでつかってるisliceはイテレータオブジェクトの頭からn回処理した結果を返す
islice: https://docs.python.org/3.6/library/itertools.html#itertools.islice
list()しない場合とでみるとわかりやすいかも
>>> from itertools import islice
>>> word = "こんにちは"
>>> islice(word, 3)
<itertools.islice object at 0x10dbf8728>
>>> list(islice(word, 3))
['こ', 'ん', 'に']
>>>
どんなことやらせてるのか
実際の処理の部分を再掲
def chunked(iterable, n):
    return iter(partial(take, n, iter(iterable)), [])
iter(iterable)でイテレータオブジェクトを生成してるpartial(take, n, iter(iterable))でtakeに対してnとiter(iterable)が与えられた状態のtake functionを生成してるiter(partial(take, n, iter(iterable)), [])で新たに生成したtake functionの返りが[]となるまで繰り返すようなイテレータオブジェクトを生成している
という感じのことだということがわかった。
